 豆包
 千问
 DeepSeek
 腾讯元宝
 Kimi
2026 年,AI 视频模型的竞争发展迅速,排名可能在几个月内就发生变化。Artificial Analysis 当前支持音频的文本生成视频排行榜显示,排名前六的模型中有五个是在 2026 年 5 月至 8 月间发布的,而 API 价格从每生成一分钟约 2.40 美元到 12 美元不等。
即便如此,选择最佳的 AI 视频模型取决于你的具体需求。运动控制、一致性、原生音频、成本和本地访问等因素都会影响哪种模型最适合你。本指南对比了最先进的 AI 视频模型,并探讨了像 Filmora.TV 这样基于工作空间的平台如何将 AI 视频作品拓展到简单生成之外。
最佳 AI 视频模型究竟应该具备什么?
在对比 AI 视频模型之前,你需要了解实际比较的是什么。简单来说,它是从文本、图像、视频参考或其他媒体等输入中生成动态画面的底层生成系统。而 AI 视频模型生成器则是让你能够使用该模型的工具或平台。
这个区别比你想象的更重要。两个不同的网站可以运行完全相同的底层模型,但为你提供完全不同的摄像机控制、渲染速度、定价和输出的结果质量。
| 因素 | 关注要点 |
|---|---|
| 提示词与运动控制 | 能够准确遵循所要求的动作、摄像机运动、构图和风格。 |
| 图片转视频质量 | 在添加自然运动的同时保持原始主体的可辨识性。 |
| 角色一致性 | 在多个镜头中保持相同的角色、产品或视觉形象。 |
| 参考控制 | 支持你使用图片、视频或其他视觉参考来引导生成结果。 |
| 便捷迭代 | 能够轻松生成、比较和优化多个版本。 |
| 生成后编辑 | 允许对生成的片段进行排列、裁剪、添加字幕、配乐,并制作成完整视频。 |
作为起点,查看 AI 视频模型基准测试或 AI 视频模型排行榜仍然很有用。例如,Google 发布了 Veo 3.1 的基准对比数据。但排名应仅作为参考信号之一。结果可能会因提示词、参考图片、时长、分辨率和模型更新而变化。
2026 年值得关注的最佳 AI 视频模型生成器
每一次新的 AI 视频模型发布都让我们以为已经达到了 AI 创作的极限,但下一个模型总能再次提高标准。尽管这些模型令人印象深刻,但它们通常在真实感、运动、叙事和创意控制方面各有所长。因此,本 AI 视频模型排名重点关注每个选项的突出优势。
AI 视频模型快速对比
| 定价模式 | 质量 | 开源 | 本地部署 | 原生音频 | |
|---|---|---|---|---|---|
| Seedance | 付费 / API | 出色的运动控制和摄像机流畅度 | |||
| Kling | 免费增值(每日积分) | 高保真真实感和物理效果处理 | |||
| Google Veo | 付费云服务 / API | 超精细 4K 提示词遵循度 | |||
| Pika | 免费增值 | 有趣的网页特效和快速社交短片 | |||
| Minimax | 开放权重 & 付费 API | 强大的多参考和视频编辑能力 | 开放权重 | ||
| HappyHorse | 付费 / 订阅 | 长片段一致性 ELO 排名领先 | 开源 | ||
| Wan | 免费开源(Wan 2.2) | 流畅的角色运动和帧控制 | 开放权重 | 是(适用于 Wan 2.2) |
1. Seedance — 最适合长篇叙事驱动的片段
这是本榜单中最新的 AI 视频模型。字节跳动的 Seedance 2.5 对于需要高端视觉连续性的用户来说是一次巨大的飞跃。它作为一款先进的 AI 图像转视频模型和人工智能文字转视频模型运行,专为处理复杂的商业叙事、产品推广和社交媒体营销活动而构建,无需不断手动拼接片段。
主要功能
- 单次生成 30 秒片段: 生成完整的 30 秒镜头,具备流畅的场景转换、角色一致性和同步的原生音频。
- 扩展的多模态参考:支持多达 50 个参考输入(包括最多 30 张图片、10 个视频片段和 10 个音频片段),以锁定角色、产品、光照和摄像机运动。
- 3D 布局与白模输入:支持你先使用粗略的 3D 几何体搭建场景,在渲染前精确控制摄像机轨迹和空间调度。
- 高级编辑:支持时间戳级别的编辑,以及绿幕编辑、摄像机视角编辑和基于参考的编辑等功能。
- 非常适合较长的、叙事驱动的 AI 视频生成。
- 能够在连续镜头之间保持更强的视听连续性。
- 强大的参考支持意味着对品牌素材有更精准的控制。
- 复杂的多主体渲染在平台高峰时段处理时间可能仍然较长。
- 设置包含大量参考输入的复杂场景需要较高的学习曲线。
- 访问方式和定价取决于你使用的平台,因此费用可能有所不同。
定价:访问方式因托管引擎的平台而异。因此,建议在你计划使用的具体平台或 API 服务上查看最新价格。
2. Kling — 最适合长镜头电影级拍摄
Kling 3.0 是一款面向电影级角色场景的多模态 AI 视频模型。它可以生成长达 15 秒的片段,支持视频原生音频、可控的摄像机方向以及基于参考的身份识别,能够保持原始身份不变,使其成为叙事视频、广告和自带对白内容的强大选择。
主要功能
- 15 秒生成:支持更长的连续场景和多镜头序列。
- 原生音频:随视觉内容一同生成对白、环境音和音效。
- 多参考控制: 使用参考媒体来保持角色、产品或场景细节的一致性。
- 全方位镜头控制:引导构图、摄像机运动、视角和场景推进。
- 4K 输出: 支持高分辨率生成,适用于更注重制作质量的工作。
- 在不同镜头切换中保持强大的角色一致性。
- 对电影级运动和场景结构有良好的控制力。
- 非常适合对白和叙事类视频。
- 拥挤的场景仍可能出现面部或交互错误。
- 复杂的提示词通常需要多次生成。
- 仅支持云端,因此不是本地 AI 视频模型。
定价:Kling 的视频 API 预付费套餐起价为 5,000 单位 700 美元。
3. Google Veo — 最适合电影级视频 + 原生音频
Veo 3.1 是 Google 当前用于生成高保真视频和同步声音的 AI 视频模型。它可以从文本或图片生成 8 秒的片段,支持强大的提示词遵循度、电影级运动和基于参考的一致性。可通过 Flow、Gemini、Google Vids、Gemini API 和 Vertex AI 使用。
主要功能
- 原生音频:生成对白、环境音和音效。
- 参考控制:使用最多三张图片来引导角色、物体和视觉风格。
- 帧控制:可通过首帧和末帧定义场景的开始和结束方式。
- 灵活的格式: 支持 16:9 和原生 9:16 输出的结果,适用于社交视频。
- 高分辨率输出: 提供 720p、1080p 和 4K 选项,其中 Google 对更高分辨率采用增强/放大处理。
- 适合电影级人工智能文字转视频模型工作流程的出色选择。
- 提供参考图片时可保持角色和场景的一致性。
- 无需单独的声音生成步骤即可将精美的视觉效果和音频结合在一起。
- 包含多个角色或快速动作的繁忙场景仍可能出现视觉或音频错误。
- 8 秒的生成时长意味着较长的故事需要多个片段或视频延展。
定价:Gemini API 定价起步为 Veo 3.1 Lite 每秒 0.05 美元、Fast 每秒 0.10 美元以及 Standard 每秒 0.40 美元,均为 720p 含音频。更高分辨率费用更高。
4. Pika — 最适合快速实验的免费 AI 视频生成器
Pika 2.5 版本是一款灵活的 AI 视频模型,可用于短文本和图生视频的实验。其免费方案适合在付费前测试提示词、特效和灵感,而付费用户最高可生成 1080p 的视频。
主要功能
- 文本与图片生成:根据你的内容描述或图片生成 5-10 秒的短片。
- Pikaswaps:主体替换现有视频中选定的对象或区域。
- Pikadditions:向素材中添加新的人物或对象。
- Pikaffects:为图片或视频添加趣味动态和物理风格特效。
- Pikaframes:使用关键帧控制转场,付费版可创建最长 25 秒的序列。
- 最易上手的免费 AI 视频模型之一,适合快速测试。
- 提供专项编辑工具,无需重建整个片段。
- 付费方案支持 720p 和 1080p。
- 免费版 Pika 2.5 生成的视频仅限 480p。
- 标准文生视频和 AI 图生视频模型生成的片段仍然较短。
- 复杂的电影级真实感和长叙事连贯性并非其主要优势。
价格:Pika 提供每月 80 个免费积分,可低分辨率使用部分生成模式。它提供标准套餐,价格为$10/月,会员套餐为$35/月,Fancy 套餐为$95/月。
5. Minimax – 最适合角色动作与表情
MiniMax H3 是一款多模态中国 AI 视频模型,适用于角色主导的场景、动作迁移和参考驱动的视频生成。它接受文本、图片、视频和音频作为上下文输入,可生成最长 15 秒的片段,原生支持立体声,输出的结果最高可达 2K。
主要功能
- 多模态输入:在一次生成中同时结合文本、图片、视频和音频参考。
- 首/末帧控制:使用一张或两张图片来控制场景的开始和结束。
- 全参考模式:支持最多 9 张图片、3 个视频和 3 个音频参考。
- 原生立体声音频:在生成画面的同时生成语音和声音。
- 开放权重:H3 于 2026 年 8 月发布了可下载的模型权重。
- 非常适合富有表现力的角色和动作密集的场景。
- 有助于从参考素材中保持视觉一致性。
- 同时提供托管访问和开放权重部署选项。
- 本地部署需要大量计算资源。
- 复杂的多模态提示词可能需要多次尝试才能获得精确结果。
- 该开放模型使用 MiniMax 社区许可证,因此不等同于宽松的 Apache 风格开源 AI 视频模型。
定价:MiniMax 月度订阅起价为$22/月,但定价页面指出 MiniMax H3 目前未包含在这些订阅方案中。按量付费方面,积分售价为 1,000 积分 = $1,充值包起价为$5。
6. HappyHorse – 最佳原生音视频合成工具
HappyHorse 1.1 是一款人工智能多模态视频模型,能够同时生成画面和声音。你可以获取观看量预期以及每日和每小时的需求分析,包括地域分布和观看时长。凭借原生音频支持和唇形驱动功能,它非常适合对话、广告、角色场景和短片电影内容。
主要功能
- 原生音视频生成:一次性生成对话、环境音和视觉动作。
- 参考转视频:使用最多 9 张图片来保持角色或产品的一致性。
- 多语言唇形驱动:将生成的语音与角色口型动作进行匹配。
- 灵活的输出的结果:支持多种屏幕高宽比,包括 16:9、9:16 和 1:1。
- 图片动画:将静态图片转化为运动驱动的 AI 图生视频模型输出的结果。
- 非常适合需要声画协调的片段。
- 使用多张参考图片时,主体一致性表现良好。
- 支持 720p 和 1080p 制作。
- 复杂运动仍可能出现物理或交互错误。
- 与一些电影级 AI 视频模型相比,逐镜头导演控制不够精细。
- 较长的生成内容可能需要额外审查以确保连贯性。
价格:HappyHorse 人工智能 提供免费套餐,包含入门积分和每日签到积分。付费月度订阅起价为每月$12.50。
7. Wan – 最佳开源 AI 视频模型
Wan 3.0 是一款多模态 AI 视频模型,适用于参考素材丰富的长作品创作。你可以从文本、图片、视频、音频、文档和网页内容生成最长 30 秒的视频(1080p)。它适用于产品广告、品牌场景以及基于现有营销素材创建的故事驱动内容。
主要功能
- 30 秒生成:支持更长的场景,无需将每个灵感拆分为短片段。
- 多源参考:接受最多 20 个参考素材,包括文本、图片、文档和网页。
- 镜头控制:支持推、拉、平移、跟随和环绕等运镜方式。
- 主体一致性:旨在跨场景保持面部、服装、产品和其他细节的稳定性。
- 集成音频:支持音频与视频同步生成,无需单独的声音处理步骤。
- 同时支持 AI 文生视频模型和图片/参考驱动的工作流程。
- 支持 480p、720p 和 1080p 输出的结果。
- 官方代码仓库使用 Apache 2.0 许可证。
- 较长的多主体场景仍需仔细审查输出的结果。
- 目前 Wan 3.0 官方 GitHub 仓库未提供模型权重或自托管说明,因此尚无法验证其是否为完全可本地部署的 AI 视频模型。
定价:提供免费版本,包含每日签到积分。付费方案起价为每月 $6.5(当前促销折扣前)。
在 Filmora.TV 上使用多个 AI 视频模型创建完整视频
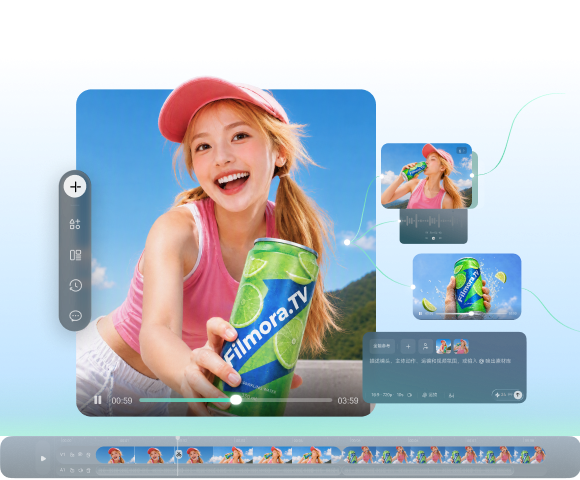
测试多个 AI 视频模型通常意味着在不同网站之间来回切换、逐一下载结果,然后在其他地方重建项目。Filmora.TV 将多个生成引擎整合到一个可视化工作区中,简化了这一流程。
你可以将同一提示词通过多个引擎运行,并排比较结果,然后将最佳片段直接拖入编辑时间轴。
什么是 Filmora.TV?
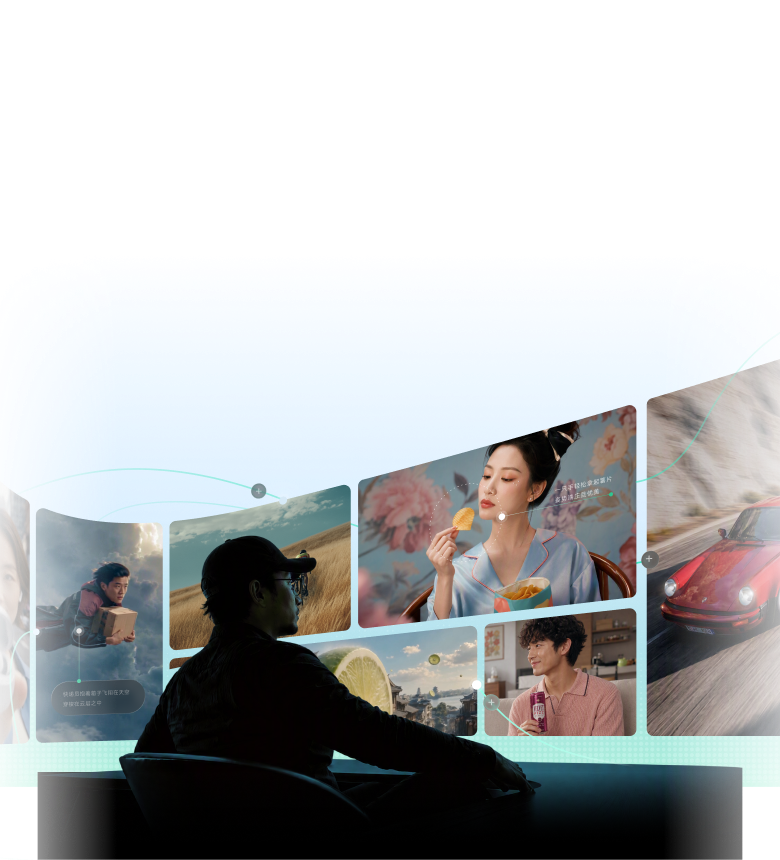
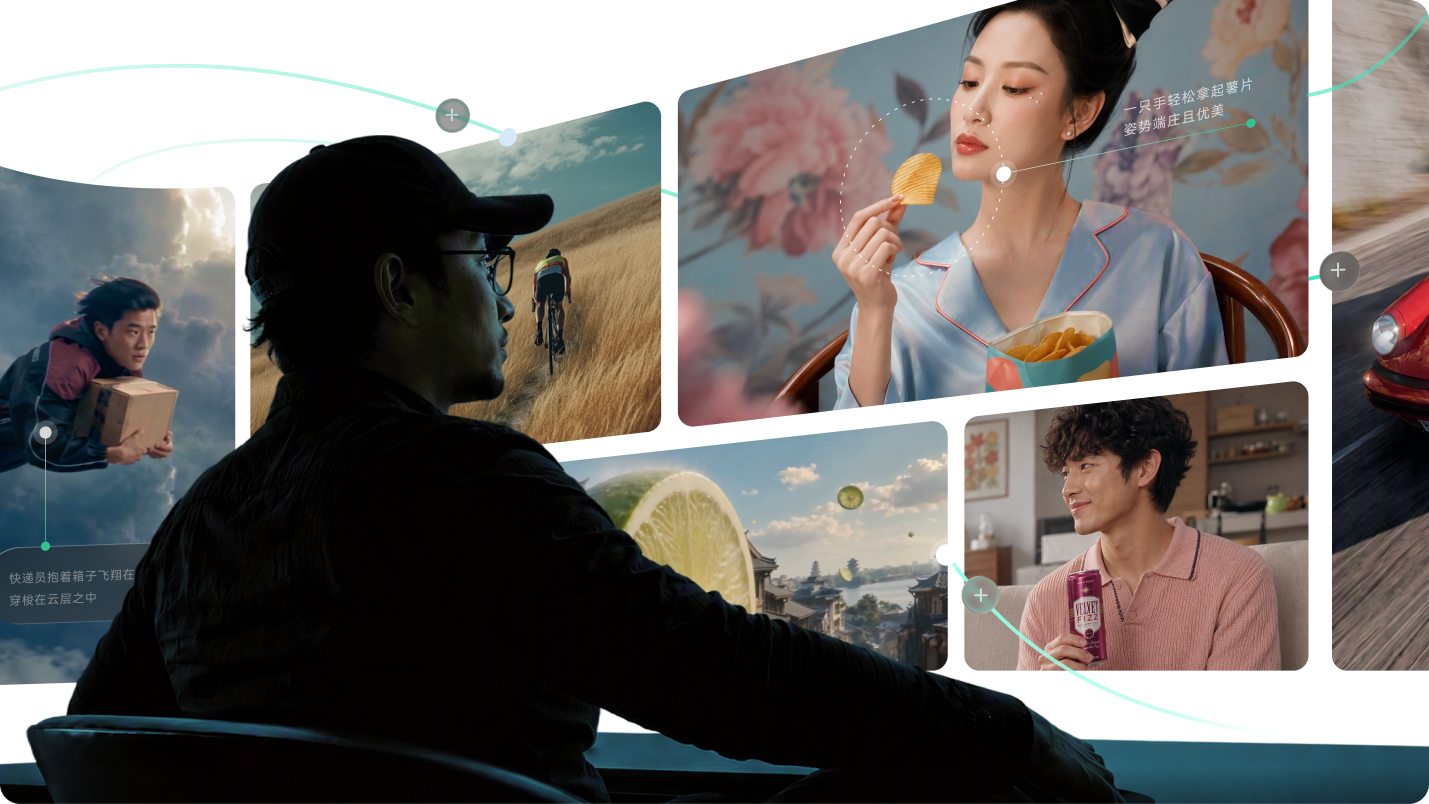
Filmora.TV 是一个围绕自由形式可视化画布构建的 AI 原生视频创作与协作工作空间。它专为电视广告、品牌内容、AI 短视频以及需要在确定最终剪辑前探索大量灵感的创意团队而设计。
你无需从固定的时间轴开始,而是可以组织:
- 文本、脚本和提示词链。
- 参考照片和商品图生成素材。
- 可视化分镜和场景概念。
- 生成的视频和其他我的素材资源。
- 并排生成结果,便于比较。
该画布作为基于节点工作流的创意面板运作。你可以将一个灵感分支为多个版本,将参考素材放在生成片段旁边,并在不丢失每次尝试背景信息的情况下比较结果。
在一个项目中访问多个 AI 视频模型
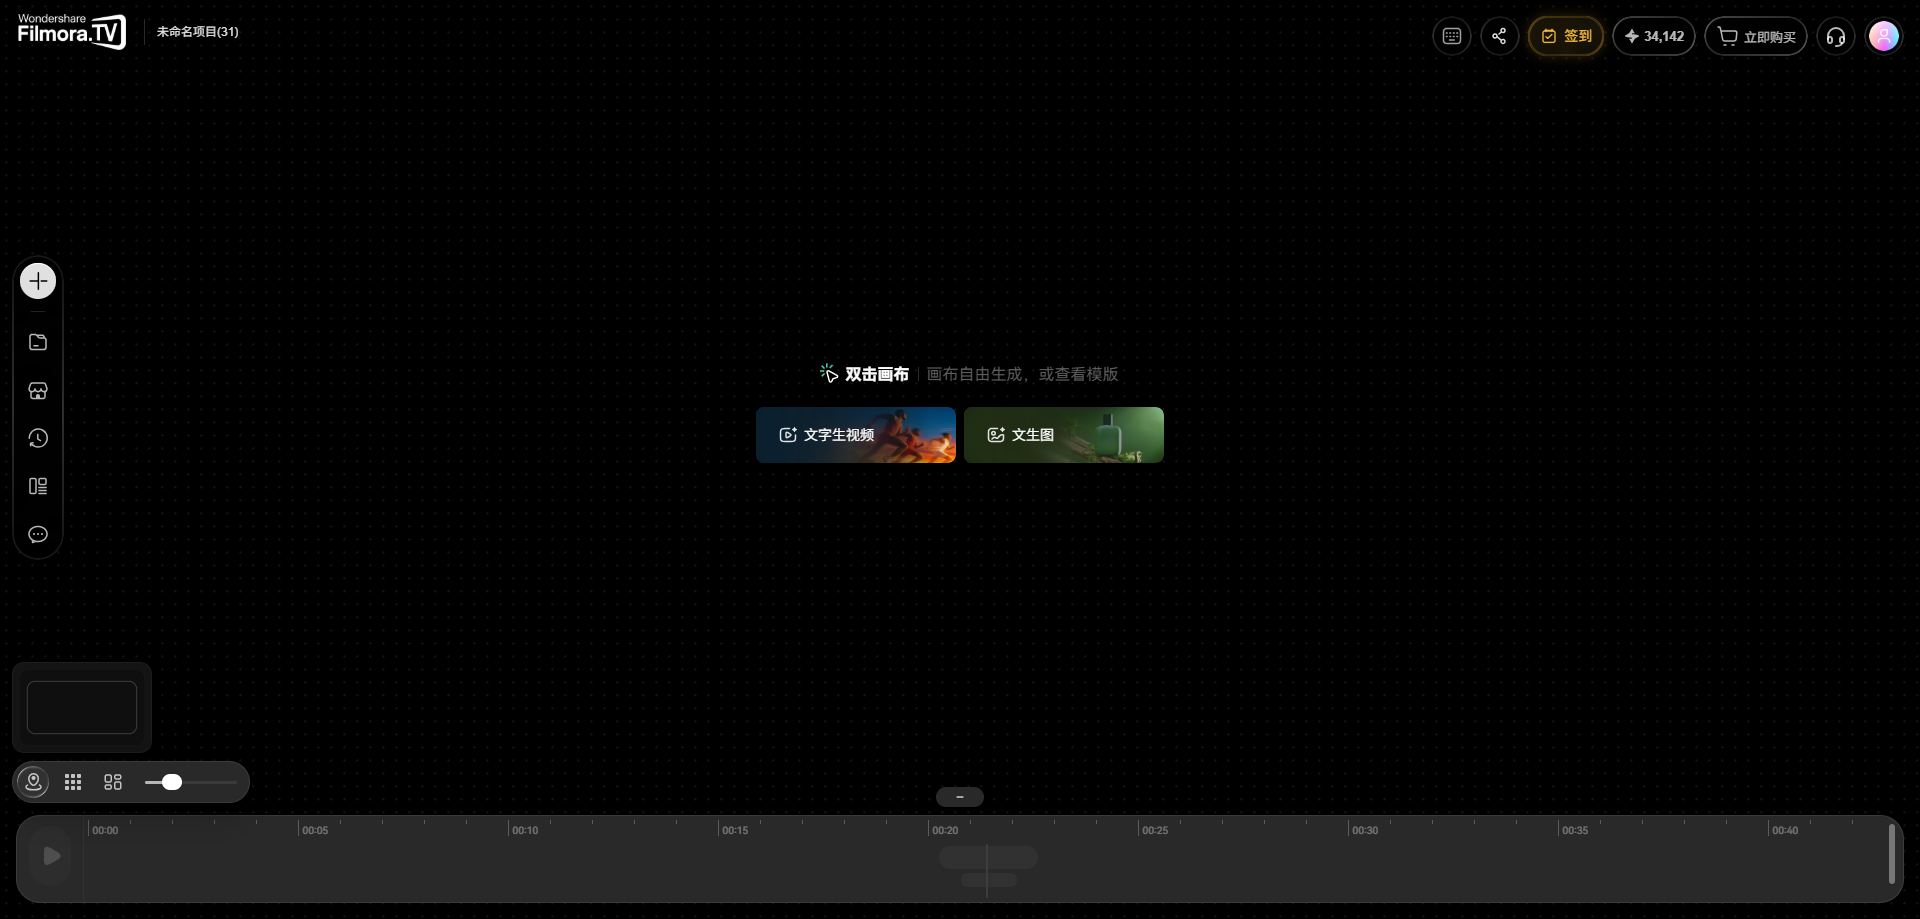
视频节点是你在 Filmora.TV 中直接生成视频内容的地方。当前工作区支持四种主要生成路径:
- 文生视频
- 图生视频
- 首末帧
- 全能参考
通过模型选择器,你可以在不离开项目的情况下切换不同的 AI 视频模型。Filmora.TV 当前可用的选项包括:
| 模型系列 | 可用模型 |
|---|---|
| Seedance | Seedance 2.0 Mini、Seedance 2.0、Seedance 2.0 Fast、Seedance 2.5 |
| HappyHorse | HappyHorse 1.0、HappyHorse 1.1 |
| MiniMax | MiniMax H3 |
| Kling | Kling 3.0、Kling Omni 3.0 |
| Gemini Omni Flash、VEO3.1、VEO3.1-Fast、VEO3.1-Lite | |
| Vidu | Vidu Q3 |
| Wan | Wan 3.0 |
工作流程原理
- 在画布上构建灵感。添加你的脚本、提示词、产品图片、角色或视觉参考素材。
- 连接视频节点。选择文本成片、图生视频、首/尾帧生成或基于参考的作品创建。
- 选择一个 AI 模型。使用 Seedance、Kling、Veo、MiniMax、Wan、Vidu 或其他可用选项测试同一场景。
- 对比生成结果。在画布上同时展示多个版本,选择最符合创作要求的那一个。
- 将选定的片段移至时间轴。Filmora.TV 内置多轨编辑器,支持视频和音频编辑。
- 完成视频。裁剪或拆分片段、调整节奏、添加音乐或字幕,然后导出完成的项目。
许多人工智能平台在生成片段后就止步不前,但 Filmora.TV 将探索和编辑阶段无缝衔接。你可以生成多个版本的 15 秒广告,将它们与原始产品参考素材并排对比,挑选最佳镜头,并直接在时间轴上排列,无需在另一个编辑器中重建项目。
对于想要对比最佳 AI 模型的创作者来说,Filmora.TV 既是一个测试工作区,也是一条从 AI 生成到成品视频的实用路径。
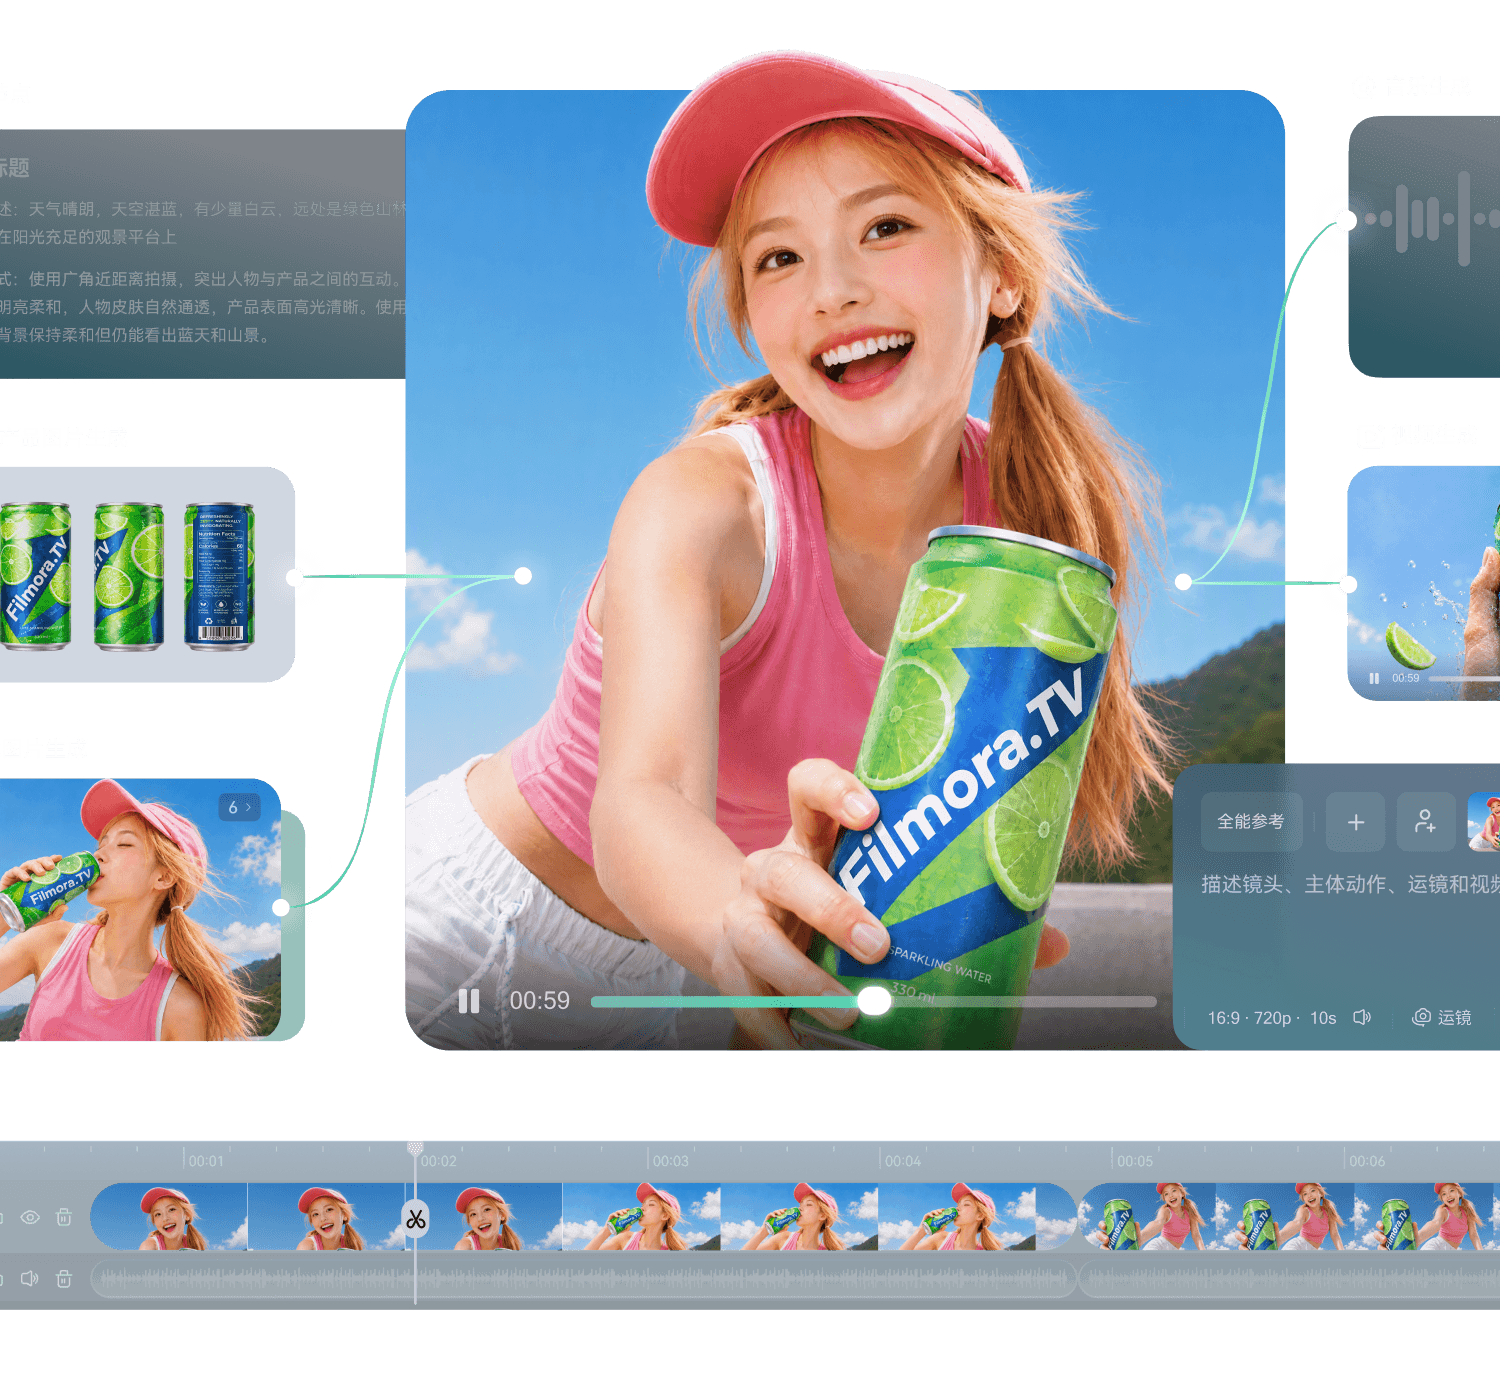
- 无限画布承载创意,让每个灵感尽情生长
- 多款 AI 模型同场比选,快速锁定最佳画面
- 画布无缝衔接时间线,从生成一路剪到成片
- 项目共享、在线评审,让团队创作高效同频
总结
这份 AI 模型对比表明,没有任何单一模型能在所有任务中领先。有些模型在电影级运镜方面更强,而另一些则在原生音频、参考控制、快速测试或开源部署方面表现突出。因此,最佳 AI 模型取决于你所需的镜头类型、输出的结果质量、预算和控制程度。
对于大型项目,更大的挑战在于如何高效管理所有生成内容。Filmora.TV 将多个模型、参考素材、输出的结果和多轨时间轴整合到一个工作区中,帮助你解决这一难题。这使得测试灵感、保留最佳片段并将其编辑成完整视频变得更加轻松,不会打断创作流程。
AI 视频模型常见问题
-
1. 有完全免费的 AI 模型吗?
有。Wan 2.2 提供可下载的模型权重和推理代码,采用 Apache 2.0 许可证。模型本身免费使用,但本地生成仍需要合适的 GPU 硬件或付费云计算资源。
-
2. 人工智能能将照片转换为视频吗?
可以。Filmora.TV 可以通过其图生视频模式将静态图片转化为动态视频。你可以上传照片,选择可用的 AI 模型,添加运动指令,然后在同一工作区内生成视频片段。
-
3. Filmora.TV 中最适合制作广告的 AI 模型是哪个?
对于以广告为主的工作,Vidu Q3-Ad 是 Filmora.TV 中最明确的选择,因为它专门标注用于短广告。Vidu 的官方广告工具支持产品图片动画、多种广告变体、1080p 输出的结果以及镜头运动控制。